Le premier incident d’un produit neuf raconte toujours la même histoire : quelqu’un signale que « ça ne marche pas », et l’équipe passe quarante minutes à établir ce qui ne marche pas exactement, pour qui, et depuis quand.
Les quatre questions
Ce sont celles qu’on se pose dans cet ordre, et un produit qui n’y répond pas en trois minutes coûtera très cher le jour où quelque chose lâchera.
- Combien d’utilisateurs sont touchés, et lesquels ?
- Depuis quand — et qu’est-ce qui a changé à ce moment-là ?
- Est-ce que ça s’aggrave, ou est-ce que c’est stable ?
- Qu’est-ce qu’on peut désactiver tout de suite pour arrêter l’hémorragie ?
La quatrième est la plus négligée
Un interrupteur qui coupe une fonctionnalité sans redéployer vaut mieux qu’un tableau de bord magnifique. Il transforme un incident majeur en dégradation acceptée, et laisse le temps de réfléchir.
Un produit qu’on ne sait pas observer est un produit dont on apprend les pannes par ses utilisateurs.
Tomás Ferreira
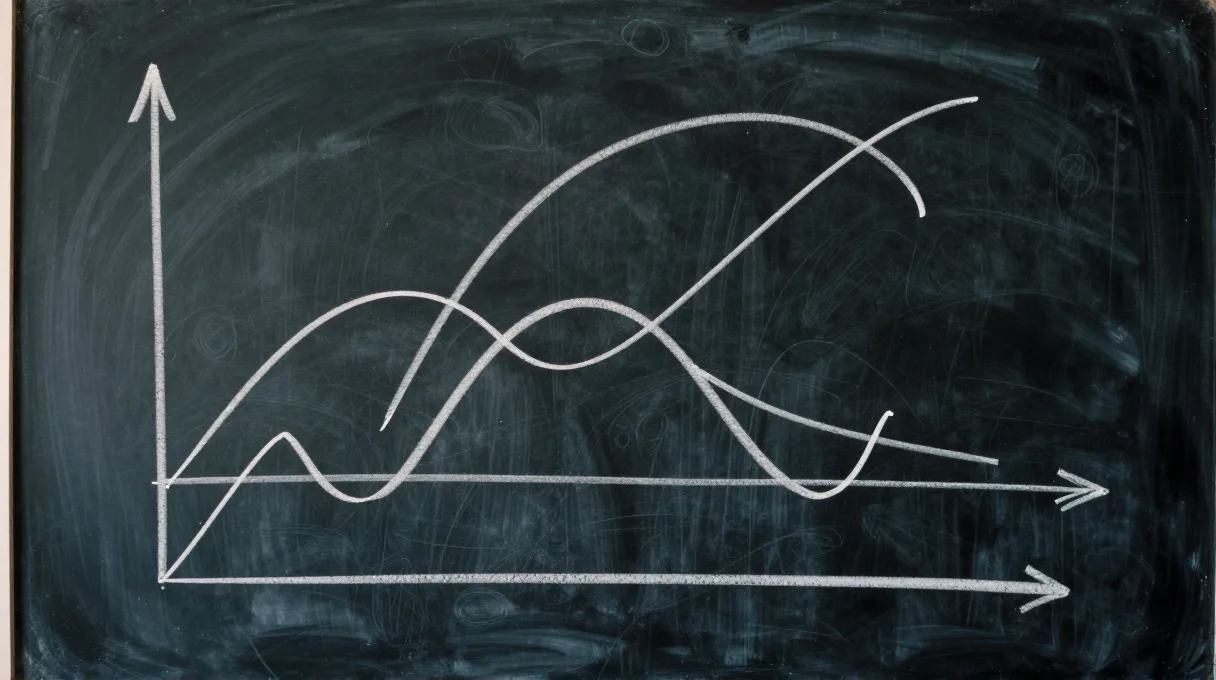
Les courbes utiles ne sont pas celles des serveurs : ce sont celles de ce que les gens arrivent à faire.
Photo — Phase Deux
Ce qu’on n’instrumente pas
La charge processeur, la mémoire, le nombre de requêtes par seconde. Ces indicateurs sont utiles à un exploitant, ils ne disent rien d’un service rendu. Sur les six derniers incidents que nous avons traités, aucun n’aurait été détecté par une alerte d’infrastructure.
La règle des trois minutes
Si vous ne pouvez pas dire, trois minutes après le signalement, combien d’utilisateurs sont touchés, la priorité n’est pas de corriger le bogue : c’est de pouvoir répondre à cette question la prochaine fois.
Laisser un commentaire